전시 데이터 플랫폼 THOR 1부 - 3.5억 개 상품 정보를 near-time으로
MongoDB , ApacheKafka , data
안녕하세요, 11번가 전시서비스개발팀 서장원입니다.
THOR는 11번가에서 지금 전시 중인 라이브 상품 약 3.5억 건의 정보를 near-time으로 갱신하고,
전시 화면에 바로 가져다 사용할 수 있게 제공하는 전시 데이터 플랫폼입니다.
이 시리즈에서는 THOR가 이렇게 많은 상품 정보를 빠르게, 그리고 빠짐없이 최신화시키는 목표 달성을 위해 어떤 구조와 기능들을 쓰는지,
시스템이 실제로 어떻게 돌아가는지 세 편에 나눠 소개합니다.
1부인 이 글에서는 THOR가 무엇이고 왜 필요했는지, 그리고 가격 변경 하나가 화면에 닿기까지 어떤 길을 지나는지 따라가 봅니다.
전시 데이터 플랫폼 THOR 시리즈
1부. 3.5억 개 상품 정보를 near-time으로 (이 글)
2부. 빠르게, 그리고 빠짐없이: 많은 변경을 늦지 않게 반영하는 방법
3부. MongoDB와 Kafka 클러스터 버전업 & 마이그레이션
목차
- 먼저 묻는 네 가지
- 숫자로 보는 THOR
- THOR를 만든 이유
- 가격 변경 하나 따라가기: 원천 DB에서 화면까지
- 한눈에 보는 THOR 구성: 변경이 들어오는 네 갈래
- 3.5억 건을 담는 상품전시DB
- 마치며
- 참고 자료
먼저 묻는 네 가지
본론에 들어가기 전에, 이 글에 자주 나올 용어부터 질문으로 풀어 보겠습니다.
전시가 무엇인가요?
전시는 고객이 보는 11번가 화면에 상품을 골라 진열하는 일입니다.
홈이나 기획전 화면에 상품 카드가 줄지어 늘어선 모습을 떠올리면 쉽습니다.
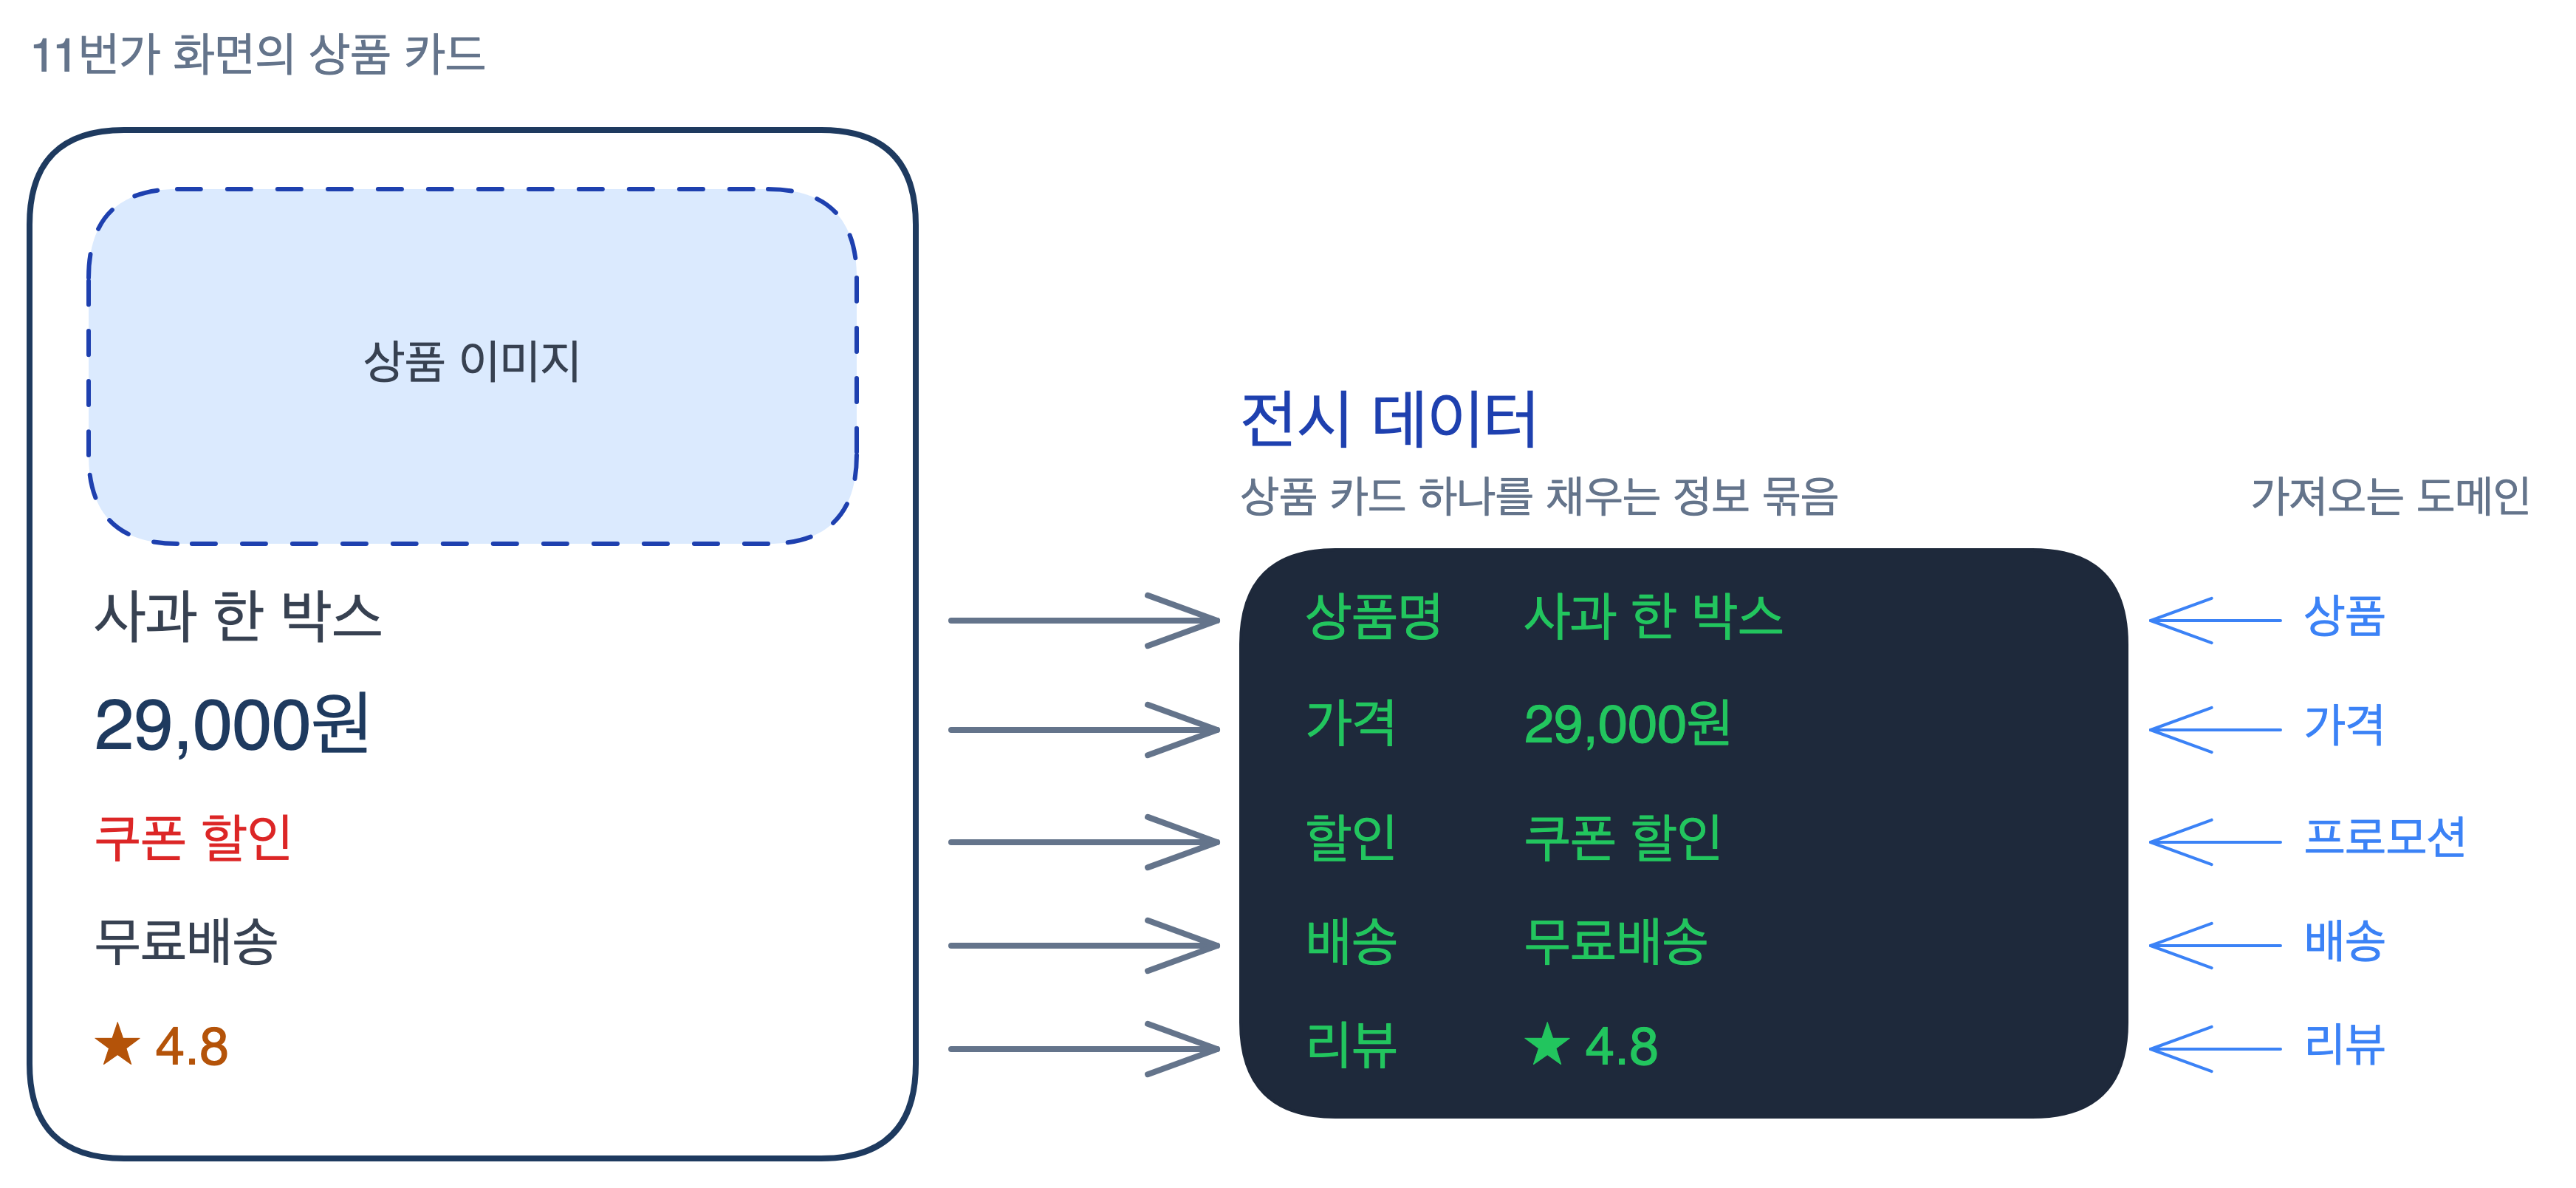
카드 하나에는 상품명, 가격, 할인, 배송, 리뷰 같은 정보가 함께 들어갑니다.
이렇게 화면의 상품 카드 리스트를 채우는 정보 묶음을 전시 데이터라고 부릅니다.
라이브 상품은요?
고객에게 전시되는 상품을 전시 상품 또는 라이브 상품이라고 합니다.
예를 들어 판매 기간이 지났거나, 판매를 멈췄거나, 전시하지 않기로 한 상품은 라이브 상품이 아닙니다.
THOR의 상품전시DB에는 원칙적으로 라이브 상품만 담깁니다.
그래서 이 글의 3.5억 건은 지금 고객에게 보일 수 있는 상품의 수입니다.
near-time은 무엇인가요?
near-time은 ‘거의 실시간’이라는 뜻으로, 바뀐 내용을 짧은 시간 안에 따라잡는다는 의미입니다.
가격을 예로 들면, 판매자가 가격을 바꾼 뒤 THOR에 반영되기까지 수 ms 수준 정도로 걸립니다.
그래서 THOR는 무엇인가요?
THOR(Thunder-fast Hub Of Refreshed display)는 MongoDB 기반의 전시 데이터 플랫폼입니다.
이름에는 전시에 필요한 여러 데이터 요구 사항에 유연하게 대응하고,
실시간으로 변경된 데이터를 빠르게 제공하는 전시 DB를 만들자는 뜻을 담았습니다.
숫자로 보는 THOR
숫자로 대용량 시스템 THOR의 규모와 처리량을 가늠해 보겠습니다.
- 라이브 상품: 전시 중인 상품만 담는 상품전시DB 기준 약 3.5억 건
- THOR가 하루에 처리하는 메시지: 약 10억 건 이상
- 메시지를 받아 처리하는 Kafka 리스너: 약 190개
- THOR가 쓰는 MongoDB 클러스터 노드: 총 60대(상품 shared 클러스터 48대, 프로모션 클러스터 9대, 가격 이력 클러스터 3대)
- THOR 데이터를 읽어 응답하는 전시 API 서버(DPWAS)의 피크: 87.9K TPS(그랜드십일절 행사)
라이브 상품은 실시간으로 새로 들어오고 빠지기 때문에, 3.5억 건을 기준으로 많게는 5천만 건 정도 늘거나 줄어듭니다.
THOR는 Kafka 기반 메시지 스트리밍(Event-Driven)으로 상품 정보를 갱신하고 전시 데이터를 만들면서, 하루 약 10억 건 이상의 메시지를 처리합니다.
THOR의 컨슈머 애플리케이션에서 토픽별로 메시지를 받는 리스너는 약 190개로, 처리에 실패한 메시지를 재처리하는 리스너도 포함되어 있습니다.
상품전시DB는 주문, 배송, 프로모션, 상품 등 전시 데이터를 담아 서빙하는 MongoDB 클러스터입니다.
약 3.5억 건을, 실시간에 가깝게.
THOR를 만든 이유
고객이 11번가에 들어와 가장 먼저 마주하는 것이 전시 화면입니다.
그래서 전시에서는 무엇보다 데이터를 빠르게 제공하는 일이 중요합니다.
그런데 상품 카드 하나를 채우는 정보는 상품, 가격, 주문, 쿠폰, 프로모션, 배송, 리뷰처럼 여러 도메인에 흩어져 있습니다.
도메인마다 데이터를 관리하는 시스템과 구조가 다르고, 저마다 복잡한 업무 규칙이 있습니다.
이 정보를 모두 모아 전시가 원하는 형태로 빠르게 제공할 방법이 필요했습니다.
THOR를 만들기 전에는 전시 화면에 보여 줄 상품 정보를 여러 팀이 함께 쓰는 공통 테이블에서 읽었습니다.
이 테이블은 PL/SQL 프로시저가 여러 원천 테이블의 값을 모아 미리 하나로 만들어 둔 것이었습니다.
그런데 전시 상품 수가 늘고 업무 로직이 복잡해지면서,
프로시저로 테이블을 만드는 방식은 한계에 이르렀고 유지보수에 드는 리소스도 계속 늘었습니다.
게다가 여러 팀이 함께 쓰는 테이블이라, 전시만을 위한 컬럼 하나를 바꾸려 해도 그 테이블을 관리하는 쪽에 요청하고 협의해야 했습니다.
개발하면서 바로 테스트해 보기도, 문제가 생겼을 때 곧바로 대응하기도 어려웠고,
전시 데이터에 이슈가 생겨도 전시서비스개발팀이 할 수 있는 일은 상당히 제한되어 있었습니다.
그래서 전시서비스개발팀은 전시 화면이 읽을 상품 정보를 공통 테이블에 기대지 않고 직접 만들기로 했고, 그렇게 만든 시스템이 THOR입니다.
지금 전시 화면은 상품정보는 대부분 THOR가 만든 데이터를 읽습니다.
전시에 필요한 데이터를 팀이 만들고 관리하니, 전시만을 위한 변경도 팀 안에서 만들고 테스트한 뒤 바로 반영할 수 있습니다.
예를 들어 전시 화면에 새 정보를 하나 더 보여 주려면, 예전에는 공통 테이블 변경을 요청하고 반영되기를 기다려야 했지만
지금은 전시서비스개발팀이 THOR 코드를 고치고 테스트한 뒤 배포하면 됩니다.
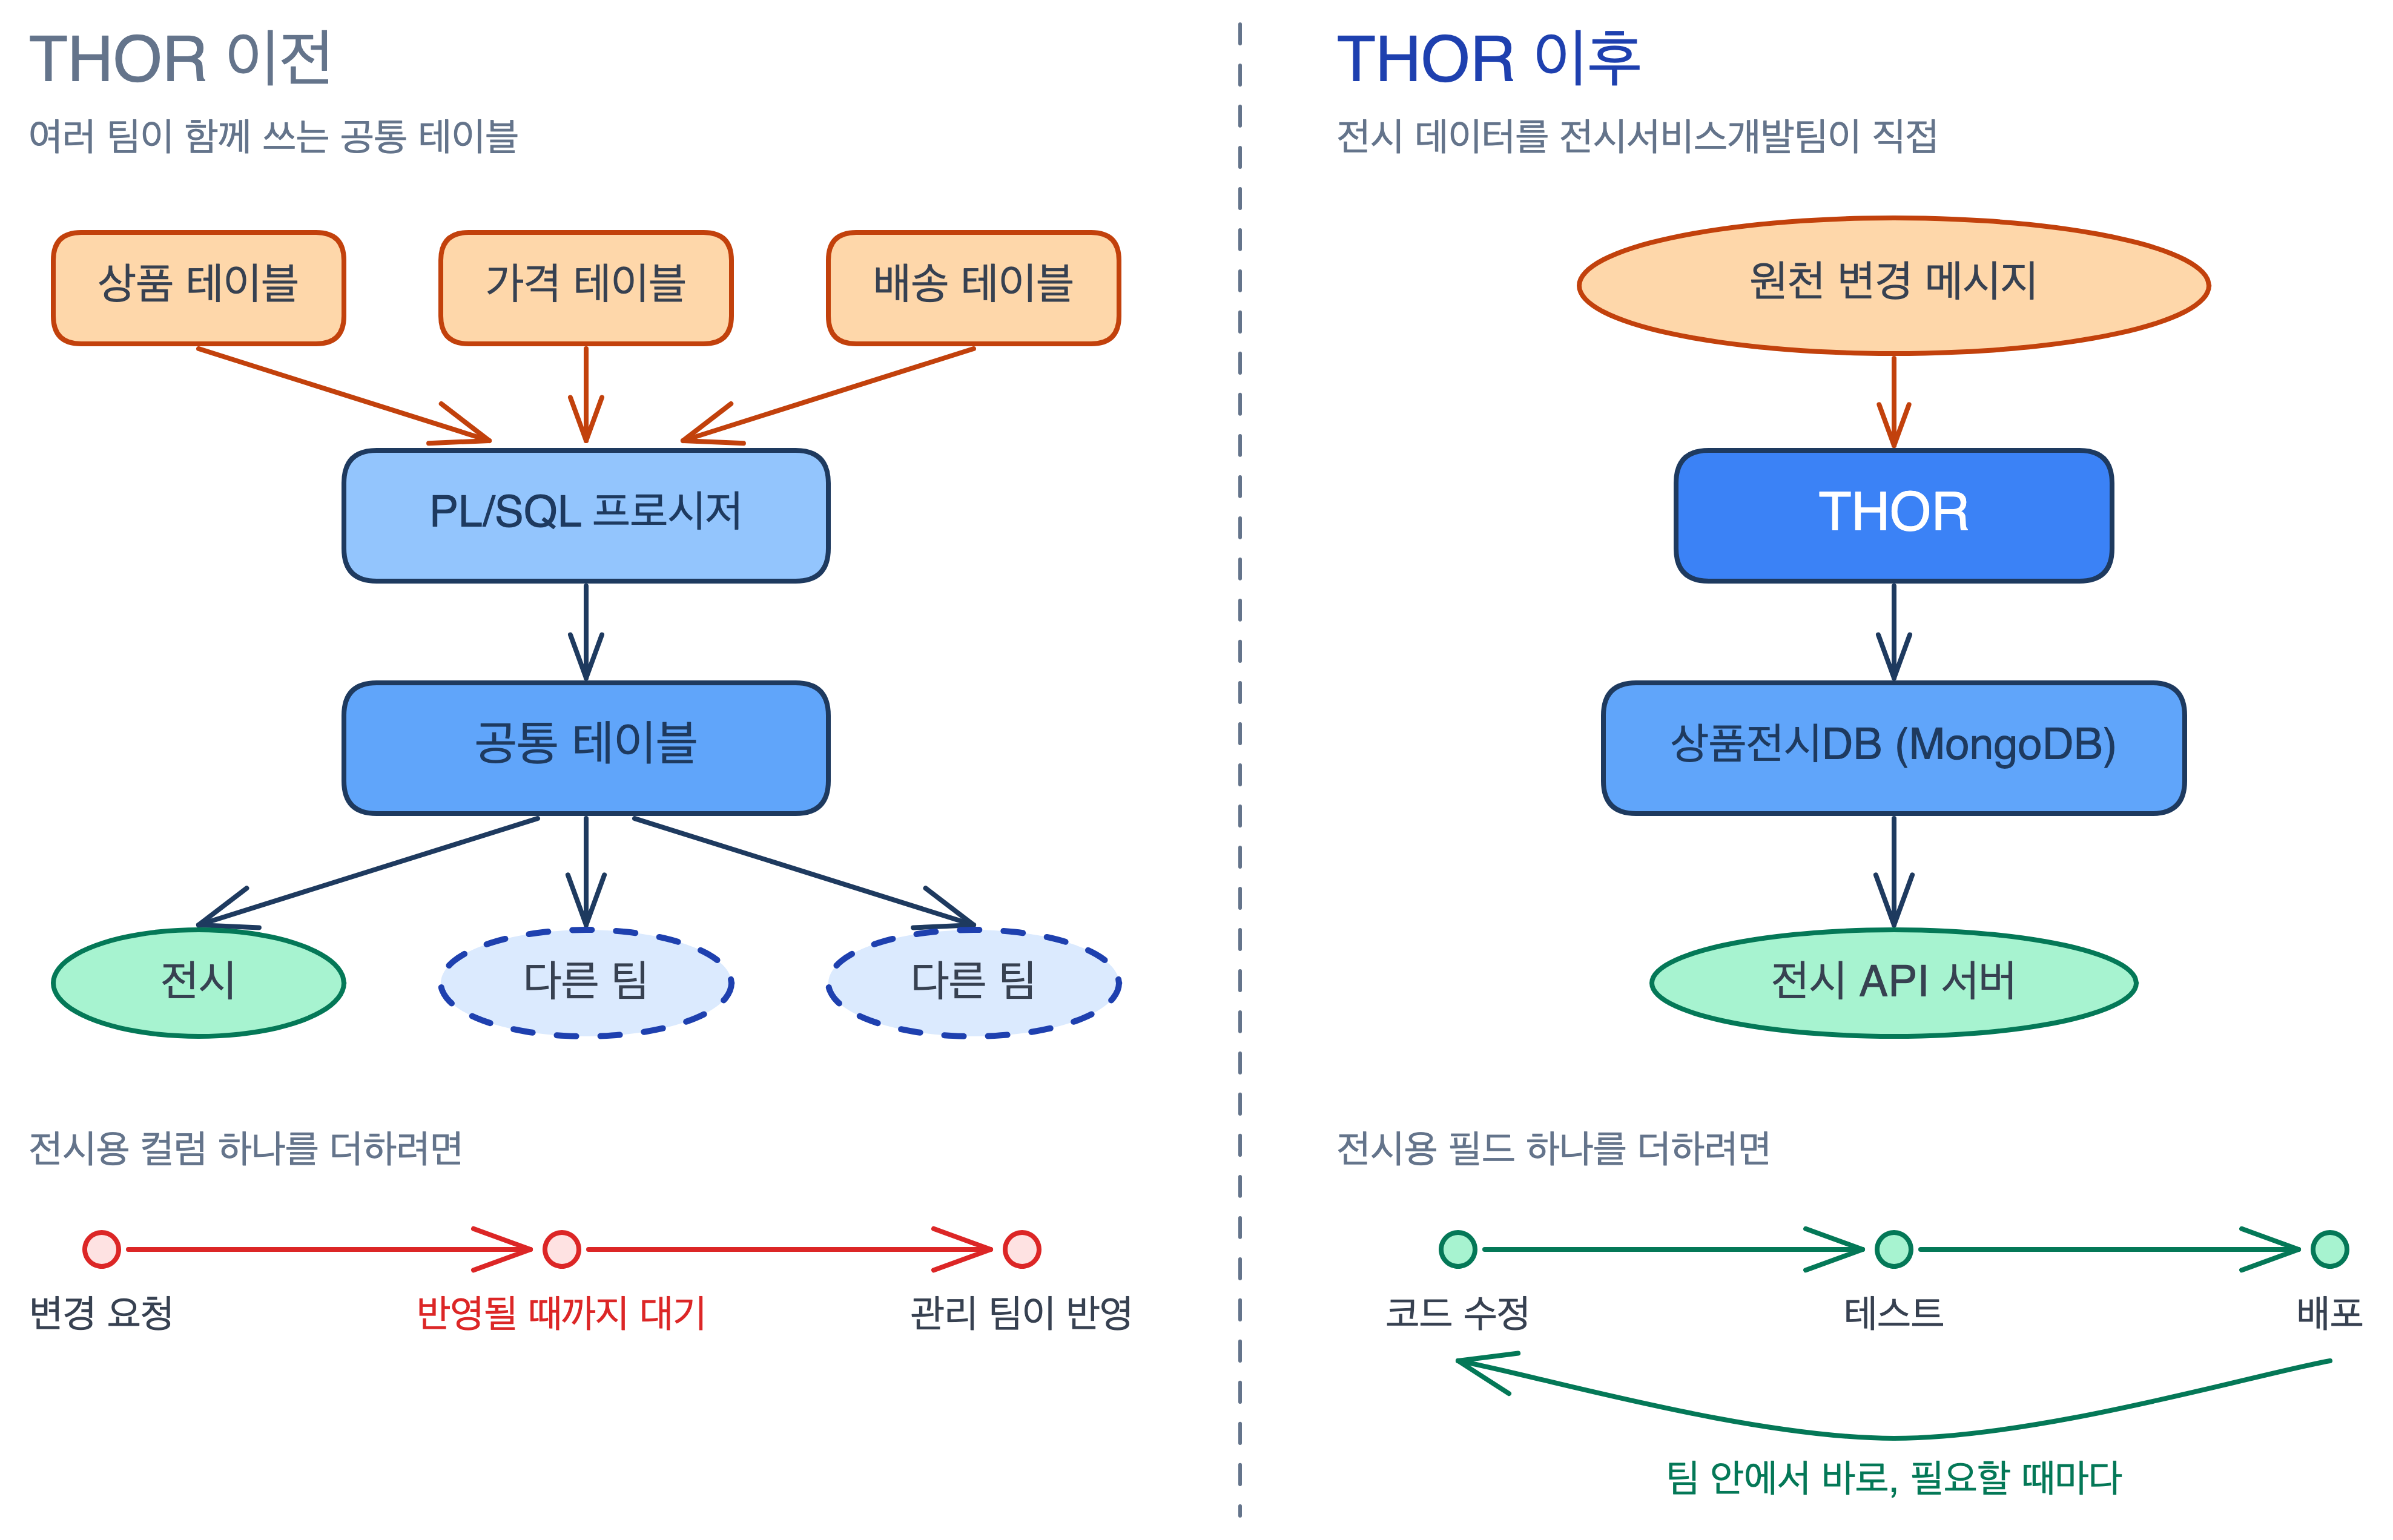
즉, 여러 도메인의 정보를 전시가 원하는 형태로 미리 모아 두고, 전시서비스개발팀이 직접 관리/운영하기 위해 THOR를 만들었습니다.
가격 변경 하나 따라가기: 원천 DB에서 화면까지
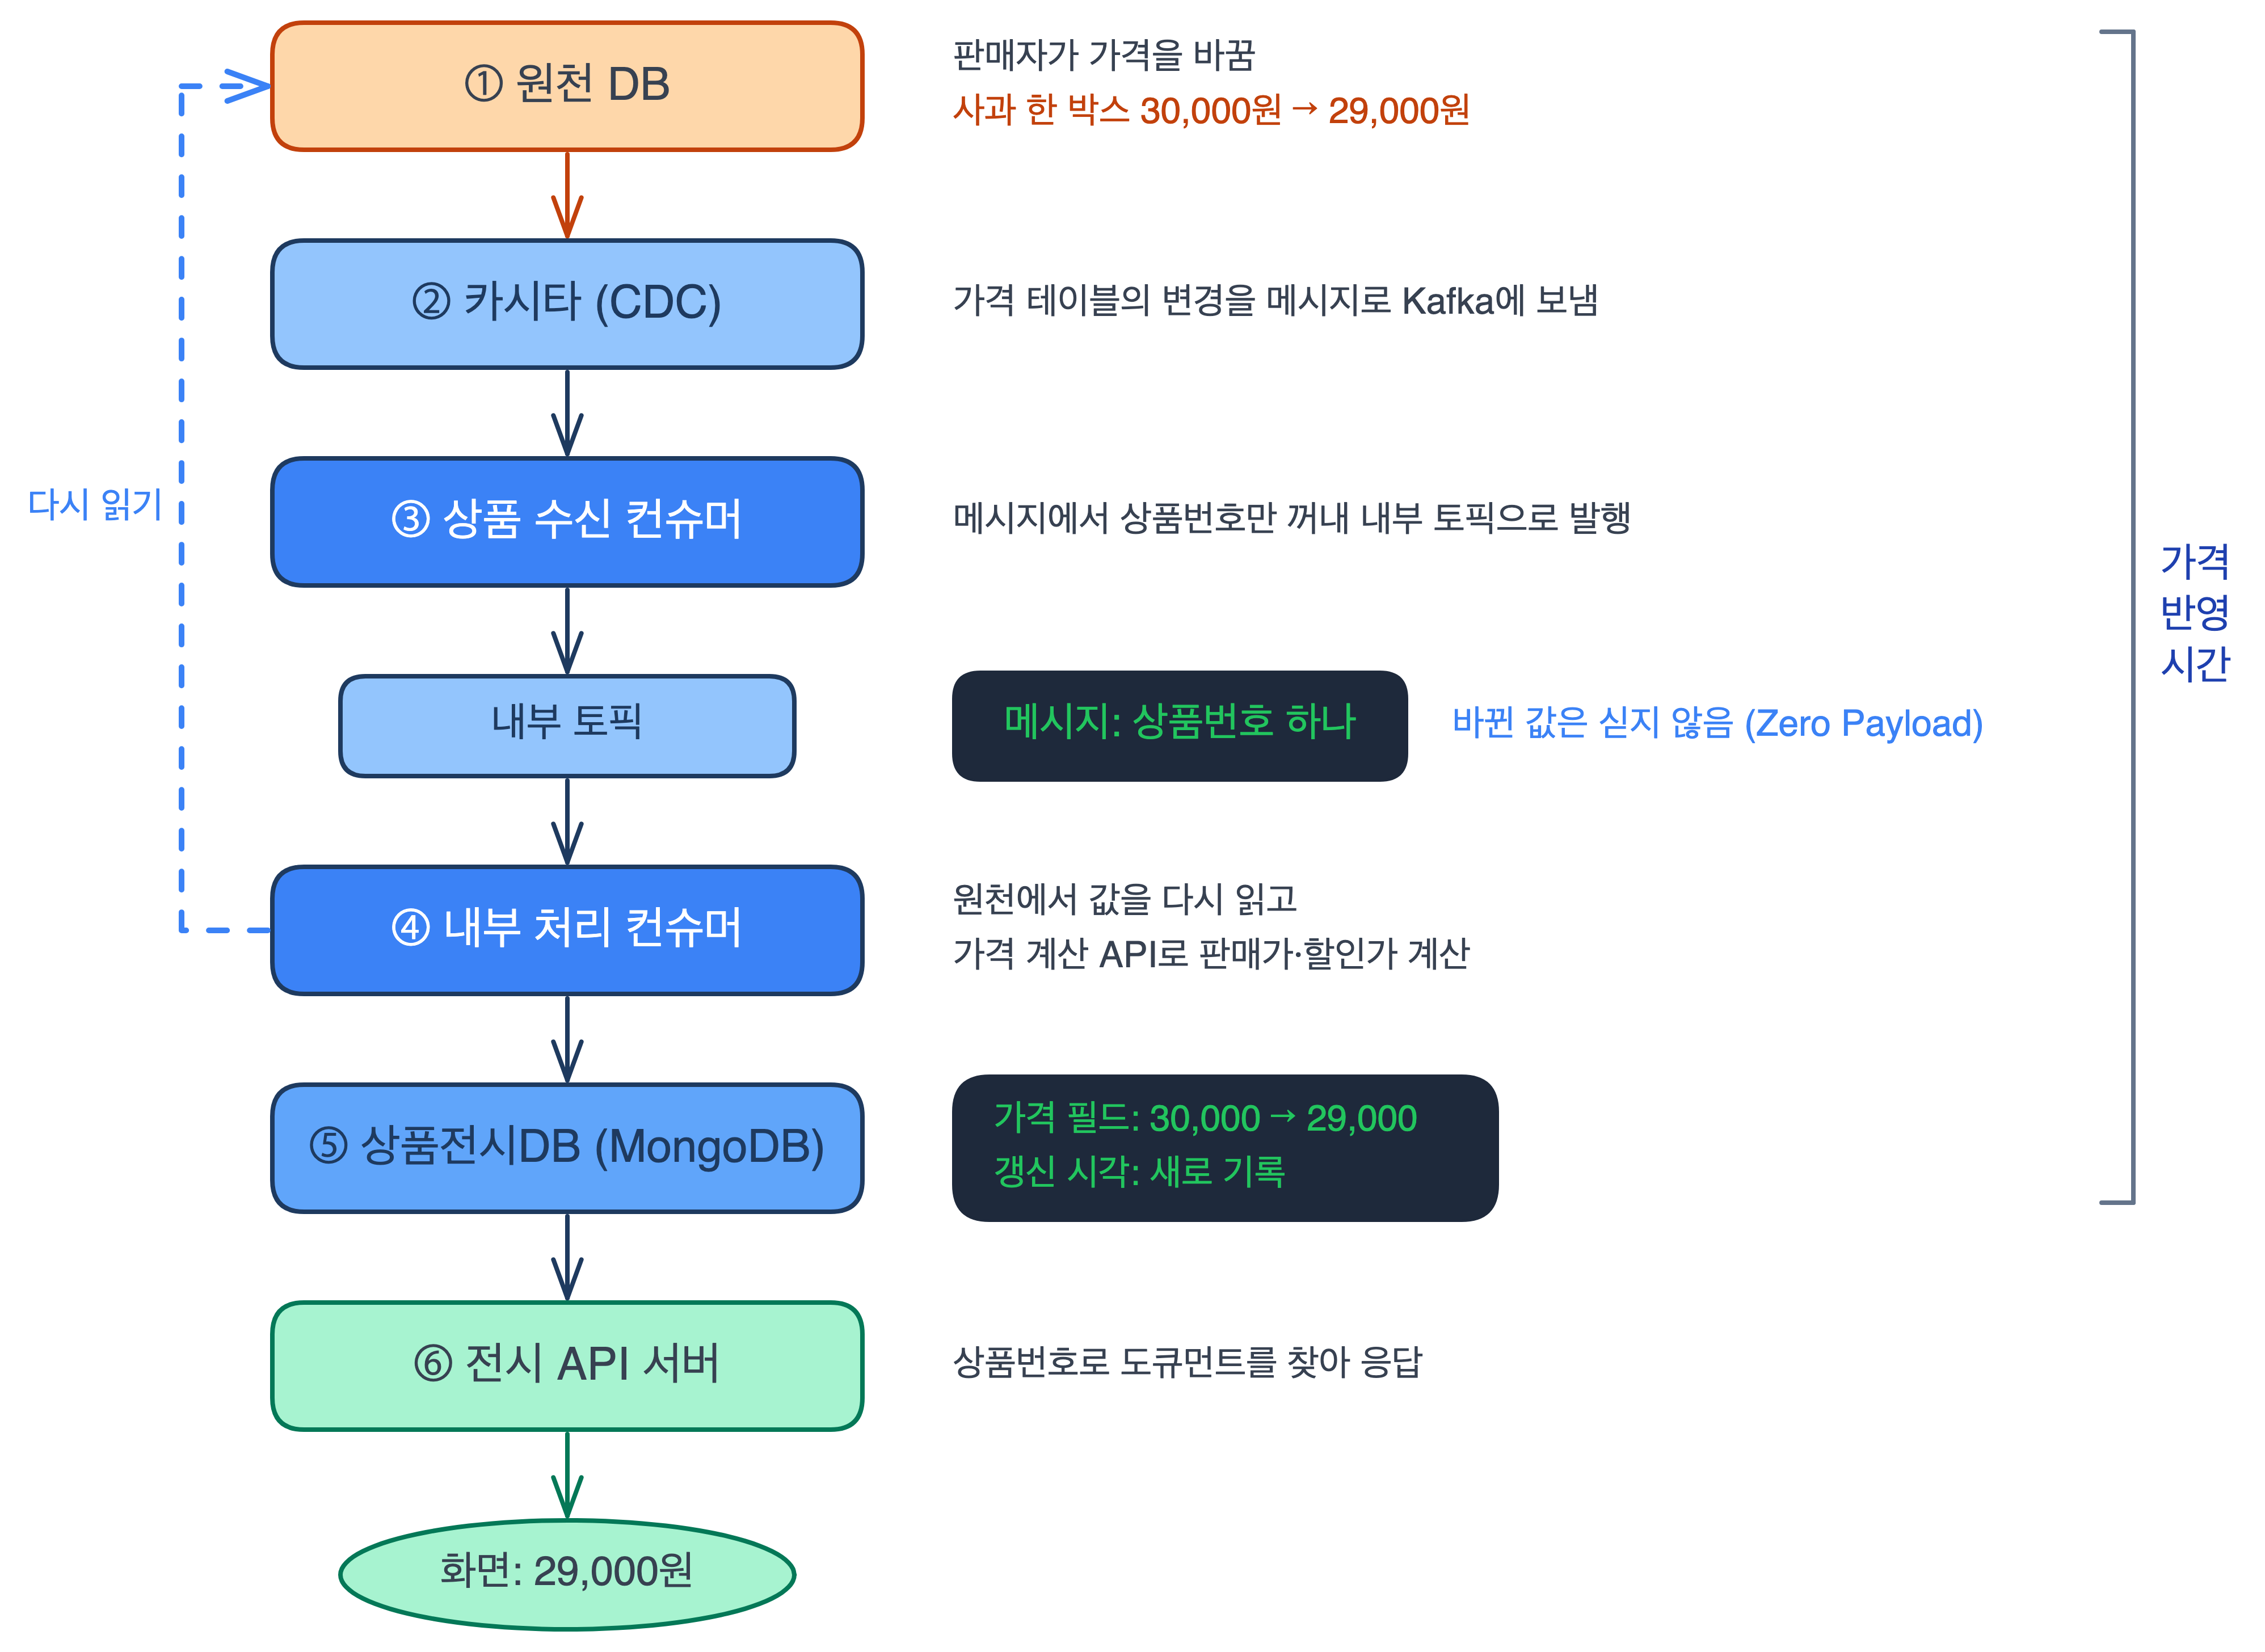
판매자가 사과 한 박스의 가격을 30,000원에서 29,000원으로 내린 경우를 예로 들겠습니다(가상의 예시입니다).
① 원천 DB: 가격 변경
판매자가 가격을 바꾸면, 상품 정보가 처음 기록되는 원천 DB의 가격 테이블이 먼저 바뀝니다.
② 카시타: 변경을 메시지로
카시타(Casita)는 DB에 생긴 변경(OGG, ADG 등)을 잡아 메시지로 보내 주는 사내 CDC(Change Data Capture) 플랫폼입니다.
‘가격 테이블에서 이 상품의 값이 바뀌었다’는 메시지가 Kafka로 나갑니다.
처음에는 원천의 변경을 모두 배치로 반영했지만, 카시타로 옮길 수 있는 것은 대부분 옮겼고, 불가한부분은 배치로 보완합니다.
③,④ 상품 수신 컨슈머: 비즈니스로직 처리
THOR의 상품 수신 컨슈머가 이 메시지를 받습니다.
상품 수신 컨슈머는 메시지에서 상품번호만 꺼내, 필요한 변동분만 필터링하고, 가격계산을 위한 데이터를 조회하며 계산로직(비즈니스)을 처리합니다.
⑤ 상품전시DB(MongoDB): 가격 필드 갱신
MongoDB에는 상품마다 화면에 필요한 기본 정보를 한데 묶은 도큐먼트가 하나씩 있습니다.
계산이 끝나면 이 상품 도큐먼트의 가격 필드와 갱신 시각을 고칩니다.
⑥ 전시 API 서버: 상품번호로 찾아 응답
고객이 화면을 열면, 전시 API 서버가 상품번호로 이 도큐먼트를 찾아 응답합니다.
화면의 사과 한 박스에는 이제 29,000원이 보입니다.
전시 API 서버는 THOR가 만든 데이터를 읽기만 하고 고치지 않습니다.
실제 경로에는 단계가 몇 개 더 있지만, 여기서는 줄기만 따라갔습니다.
앞에서 말한 가격 반영 시간은 판매자가 가격을 바꾼 때부터 상품전시DB의 도큐먼트가 고쳐질 때까지 걸리는 시간입니다.
눈여겨볼 곳은 메시지를 넘기는 방식입니다.
내부 토픽으로 넘어간 메시지에 담긴 것은 상품번호 하나뿐이었고, 값은 내부 처리 컨슈머가 원천에서 다시 읽었습니다.
이렇게 메시지에 바뀐 값(payload)을 싣지 않고 ‘바뀌었다’는 신호만 보내는 방식을 Zero Payload라고 부릅니다.
처리하는 순간 원천에 있는 값을 다시 읽으므로, 메시지가 어떤 순서로 도착했는지 신경 쓰지 않아도 됩니다.
메시지 순서를 지키려고 하면 처리량이 줄어든다고 보았고, 이 방식으로 그 부담을 덜었습니다.
그럼 처리하다 실패하면 어떻게 될까요?
가격 변경이 지나는 컨슈머는 처리 중에 실패하면 메시지를 버리지 않고 DLT(Dead Letter Topic)로 옮겨 다시 처리합니다.
내부 처리 컨슈머는 처리하는 시점에 원천 값을 다시 읽으므로, 늦게 재처리되더라도 최신의 가격값이 반영됩니다.
한눈에 보는 THOR 구성: 변경이 들어오는 네 갈래
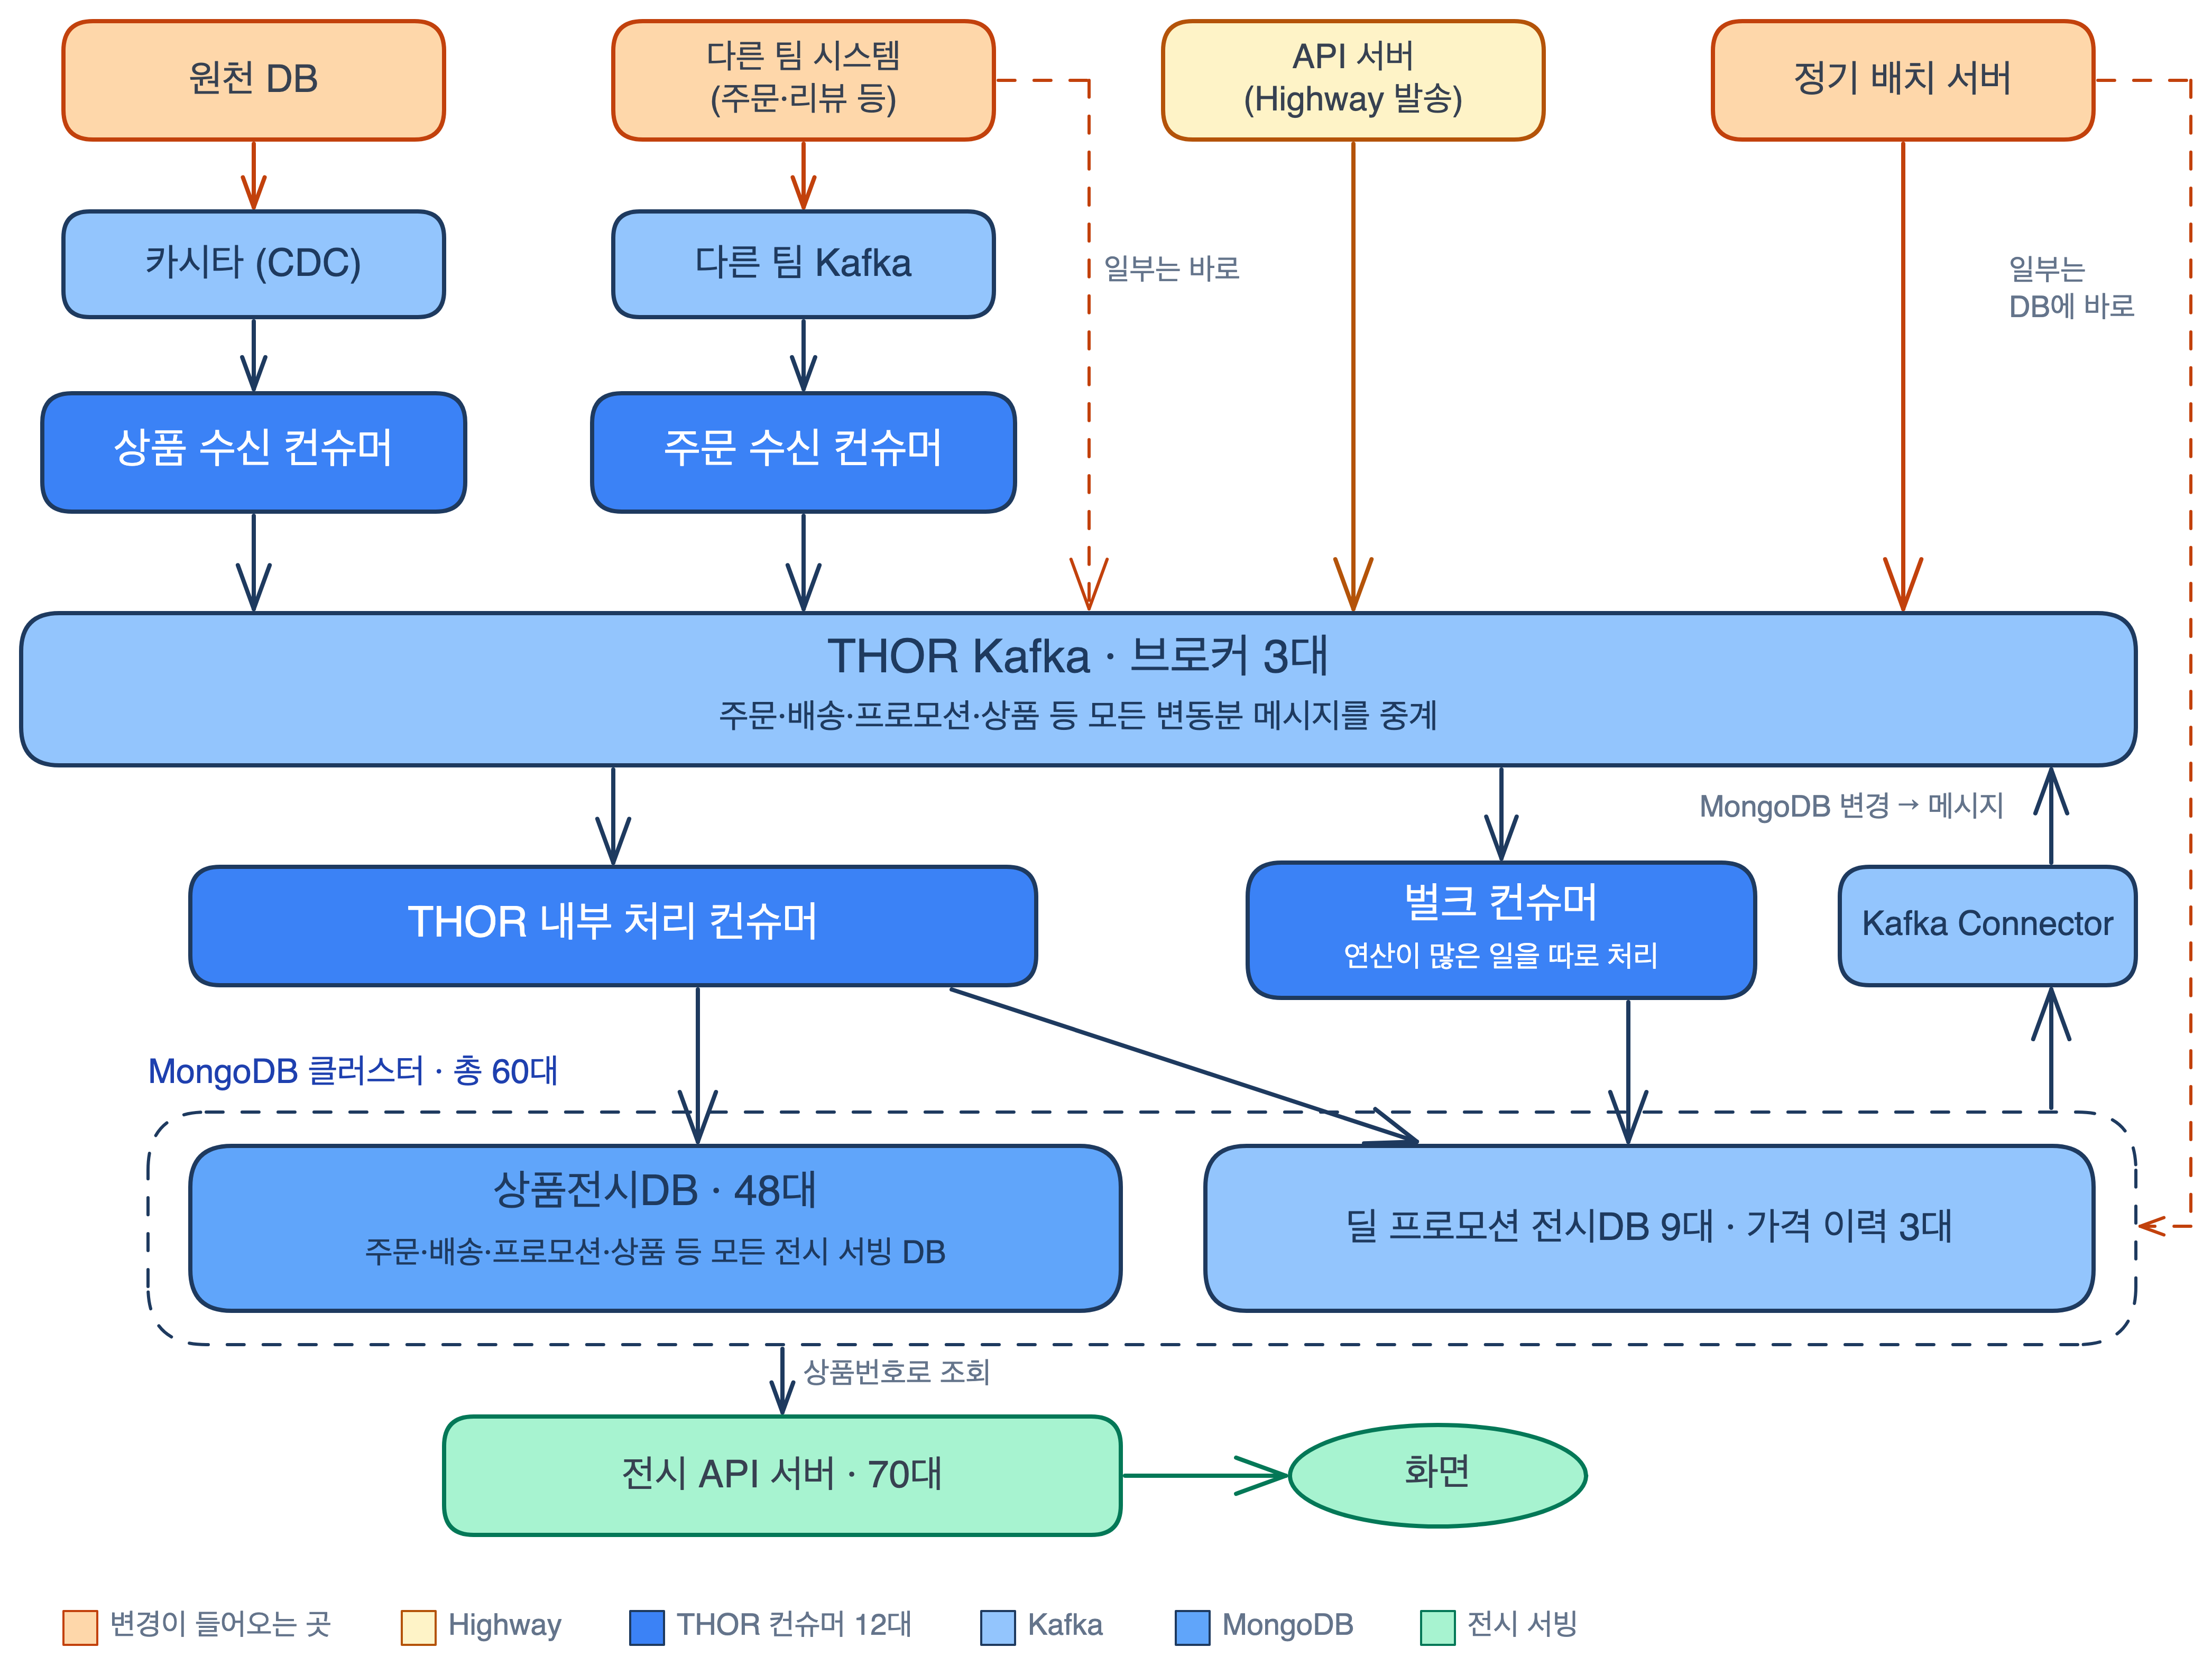
가격 변경은 카시타를 거쳐 들어왔지만, THOR로 변경이 들어오는 길은 크게 네 갈래입니다.
- 카시타 실시간 경로: 원천 DB에 생긴 변경을 카시타가 메시지로 보내 주면, THOR가 받아 반영합니다.
- 다른 팀이 보내는 메시지: 주문이나 리뷰처럼 다른 팀 시스템이 THOR로 보내 주는 메시지를 받아 반영합니다.
- 배치: 정해진 주기로 실행되면서 값을 보정하거나 많은 양을 한 번에 적재하고, 일부는 메시지를 거치지 않고 MongoDB에 바로 씁니다.
- Highway: 상품을 곧바로 최신으로 맞출 때 쓰는 별도 파이프라인입니다.
들어온 메시지는 대부분 THOR 내부 처리 컨슈머가 처리합니다.
셀러단위의 변경을 상품 단위로 나누는 일처럼, 처리량보다 연산이 많이 필요한 일은 성능이 높은 컨슈머가 따로 맡습니다.
Highway는 다른 세 갈래와 성격이 조금 다릅니다.
THOR의 기본 경로에서는 가격이 바뀌면 가격 필드만 고치는 식으로, 바뀐 영역의 필드만 갱신합니다.
Highway는 처리가 밀려 갱신이 늦어졌을 때, 또는 홈의 중요한 상품이나 갱신이 누락된 상품이 있을 때 씁니다.
전용 토픽과 전용 컨슈머 그룹을 써서 기본 경로에 밀린 메시지 뒤에 줄 서지 않고,
Highway로 들어온 상품번호의 상품만 원천에서 다시 읽어 도큐먼트를 통째로 새로 만듭니다.
처리가 늦어지는지는 늘 지켜봅니다.
kafka-ui에서는 토픽과 컨슈머 그룹별 lag 현황을 확인하고, Prometheus가 kafka_exporter로 모은 Kafka 지표는 Grafana 대시보드로 봅니다.
컨슈머 lag가 일정 시간 이상 이어지면 Slack으로 알림이 옵니다.
알림을 받으면 메시지 내역을 확인해 늦어진 상품을 Highway로 보내 바로잡고,
직원에게 이슈를 제보받았을 때도 같은 방법으로 바로 처리할 수 있습니다.
3.5억 건을 담는 상품전시DB
이제 3.5억 건이나 되는 상품 정보가 어떤 모양으로 담겨 있는지 살펴봅니다.
상품 하나에 도큐먼트 하나
THOR는 상품 정보를 MongoDB에 담고, 상품 하나를 도큐먼트 하나로 저장합니다.
도큐먼트 하나에 화면의 상품 카드 하나를 채우는 기본 정보가 들어 있습니다.
THOR가 상품 도큐먼트 하나를 처음부터 만들 때는, 여러 곳에서 따로 관리되는 정보를 모아 한 도큐먼트로 합칩니다.
딜 정보는 상품전시DB와 따로 둔 딜 프로모션 전시DB에, 가격 이력은 가격 이력 클러스터에 담습니다.
가격 이력은 상품 도큐먼트의 가격이 바뀔 때, 그 전시DB(MongoDB)변경, 즉 oplog를 수집하여 이력을 기록합니다.
THOR에 MongoDB가 잘 맞는 이유
THOR가 전시 데이터를 담는 방식과 MongoDB의 특성이 잘 맞는 지점은 네 가지입니다.
1. 조인 없이, 도큐먼트 한 건으로 읽습니다.
조회할 때 조인하지 않아도 되도록 데이터를 설계하는 것은 NoSQL 도큐먼트 모델의 핵심입니다.
MongoDB 공식 문서도 ‘함께 읽는 데이터는 함께 저장한다’를 데이터 모델링의 기본 원칙으로 꼽고,
관련 데이터를 한 도큐먼트에 묶어 두면 여러 컬렉션에 걸친 복잡한 조인을 피하면서 읽기 성능을 높이고 시스템 부하도 줄일 수 있다고 설명합니다.
정규화된 관계형 모델이라면 상품 카드 하나를 그릴 때마다 상품, 가격, 배송, 혜택 테이블을 조회 시점에 조인해야 합니다.
THOR는 이 조인을 조회할 때가 아니라 데이터를 저장할 때 미리 해 둡니다.
원천 값이 바뀌면 THOR가 상품 도큐먼트에 합쳐 두므로, 전시 API 서버는 상품 정보를 읽을 때 조인 없이 상품마다 도큐먼트 한 건만 읽으면 됩니다.
2. 상품번호로 필요한 샤드에만 요청을 보냅니다.
상품 컬렉션은 상품번호를 샤드 키로 삼아 13개 샤드에 나뉘어 있습니다.
상품번호는 새 상품일수록 커지는 번호라, 값의 범위로 샤드를 나누면 새 상품의 쓰기가 가장 큰 범위를 맡은 샤드 한 곳에 몰립니다.
그래서 상품번호를 해시한 값으로 샤드를 나누는 해시 샤딩(hashed sharding)을 써서, 데이터와 쓰기가 13개 샤드에 고르게 퍼지게 했습니다.
요청을 받아 샤드로 보내는 라우터인 mongos는, 조회 조건의 샤드 키 값으로 담당 샤드를 찾을 수 있으면
config server에 담긴 클러스터 메타데이터를 보고 그 샤드에만 요청을 보냅니다.
샤드 키가 없는 조회는 다른 필드에 인덱스가 있더라도 모든 샤드에 요청을 보내고 응답을 모아야 합니다.
해시 샤딩에서는 범위로 찾는 조회가 여러 샤드로 퍼지기 쉽지만, 같은 값을 찾는 조회는 mongos가 해당 샤드로 바로 보냅니다.
전시 API 서버는 상품 도큐먼트를 읽을 때 상품번호 목록 하나만 조건으로 걸어 값으로 찾습니다.
3. 필요한 값이 모두 인덱스에 있는 조회는 인덱스만으로 답합니다.
THOR는 상품 도큐먼트와 별도로, 상품을 찾는 데 필요한 필드만 모은 검색용 인덱스 컬렉션을 만들어 둡니다.
전시 API 서버가 상품 그룹마다 대표 상품을 고를 때는 이 컬렉션을 조회합니다.
조건과 정렬에 쓰는 필드(그룹 키, 판매 상태, 점수, 가격)와 돌려받는 상품번호가 모두 한 복합 인덱스에 들어 있어,
이 조회는 도큐먼트를 읽지 않고 인덱스만으로 답하는 커버드 쿼리(covered query)로 동작하도록 했습니다.
THOR 컨슈머도 상품번호가 상품전시DB에 있는지만 확인할 때는 상품번호로만 조회하고 상품번호만 돌려받아, 인덱스만으로 답하도록 했습니다.
즉시할인 쿠폰처럼 한 번에 아주 많은 상품에 걸리는 변경을 처리할 때 이 조회를 씁니다.
4. 도큐먼트 구조가 자유롭습니다.
MongoDB는 스키마가 유연한 NoSQL 데이터베이스여서, 같은 컬렉션의 도큐먼트라도 필드 구성이나 데이터 타입이 같을 필요가 없습니다.
도큐먼트 안에는 하위 도큐먼트와 배열을 넣을 수 있어,
카테고리, 옵션, 혜택, 배송 정보처럼 구조가 있는 정보도 상품 도큐먼트 하나에 그대로 담깁니다.
전시에 새 정보가 필요하면 테이블 구조를 바꾸는 작업(ALTER TABLE) 없이 필드를 더해 바로 쓰기작업을(write) 합니다.
실제로 전시 API 서버가 상품 서버의 이미지 API를 따로 호출해 받던 목록 이미지와 카드뷰 이미지 주소를 도큐먼트에 적재하여 API 추가호출을 줄였습니다.
그러자 상품 서버 호출이 1000건당 80.8회에서 43.5회로 줄었습니다 (약 46%).
전시 요구가 자주 바뀌어도 팀 안에서 빠르게 반영하고 테스트할 수 있는 데에는 이 구조도 한몫합니다.
13개 샤드와 복제 세트
상품전시DB는 13개 샤드로 이루어진 sharded cluster입니다.
샤드마다 mongod 3대가 복제 세트(replica set)를 이루므로, 데이터를 담는 mongod만 39대입니다.
여기에 앞에서 본 mongos 6대와 config server 3대가 더해집니다.
샤딩과 복제를 함께 쓰는 이 구조에는 세 가지 장점이 있습니다.
- 고가용성: 각 샤드의 primary에 문제가 생기면 남은 secondary 가운데 하나가 선출되어 새 primary가 됩니다. 서버 한 대가 멈춰도 자동으로 서빙을 이어 가고, 샤드 하나가 통째로 멈추더라도 나머지 샤드의 데이터는 계속 읽고 쓸 수 있습니다.
- 읽기 분산: 쓰기는 각 샤드의 primary가 받고, 전시 API 서버의 읽기는 secondary를 우선해(secondaryPreferred) 보냅니다. 그래서 전시 화면에서 몰려드는 읽기 요청이 각 샤드의 secondary로 나뉩니다.
- 수평 확장: 데이터와 요청이 늘면 샤드를 더해 저장 용량과 읽기·쓰기 처리량을 함께 늘릴 수 있습니다.
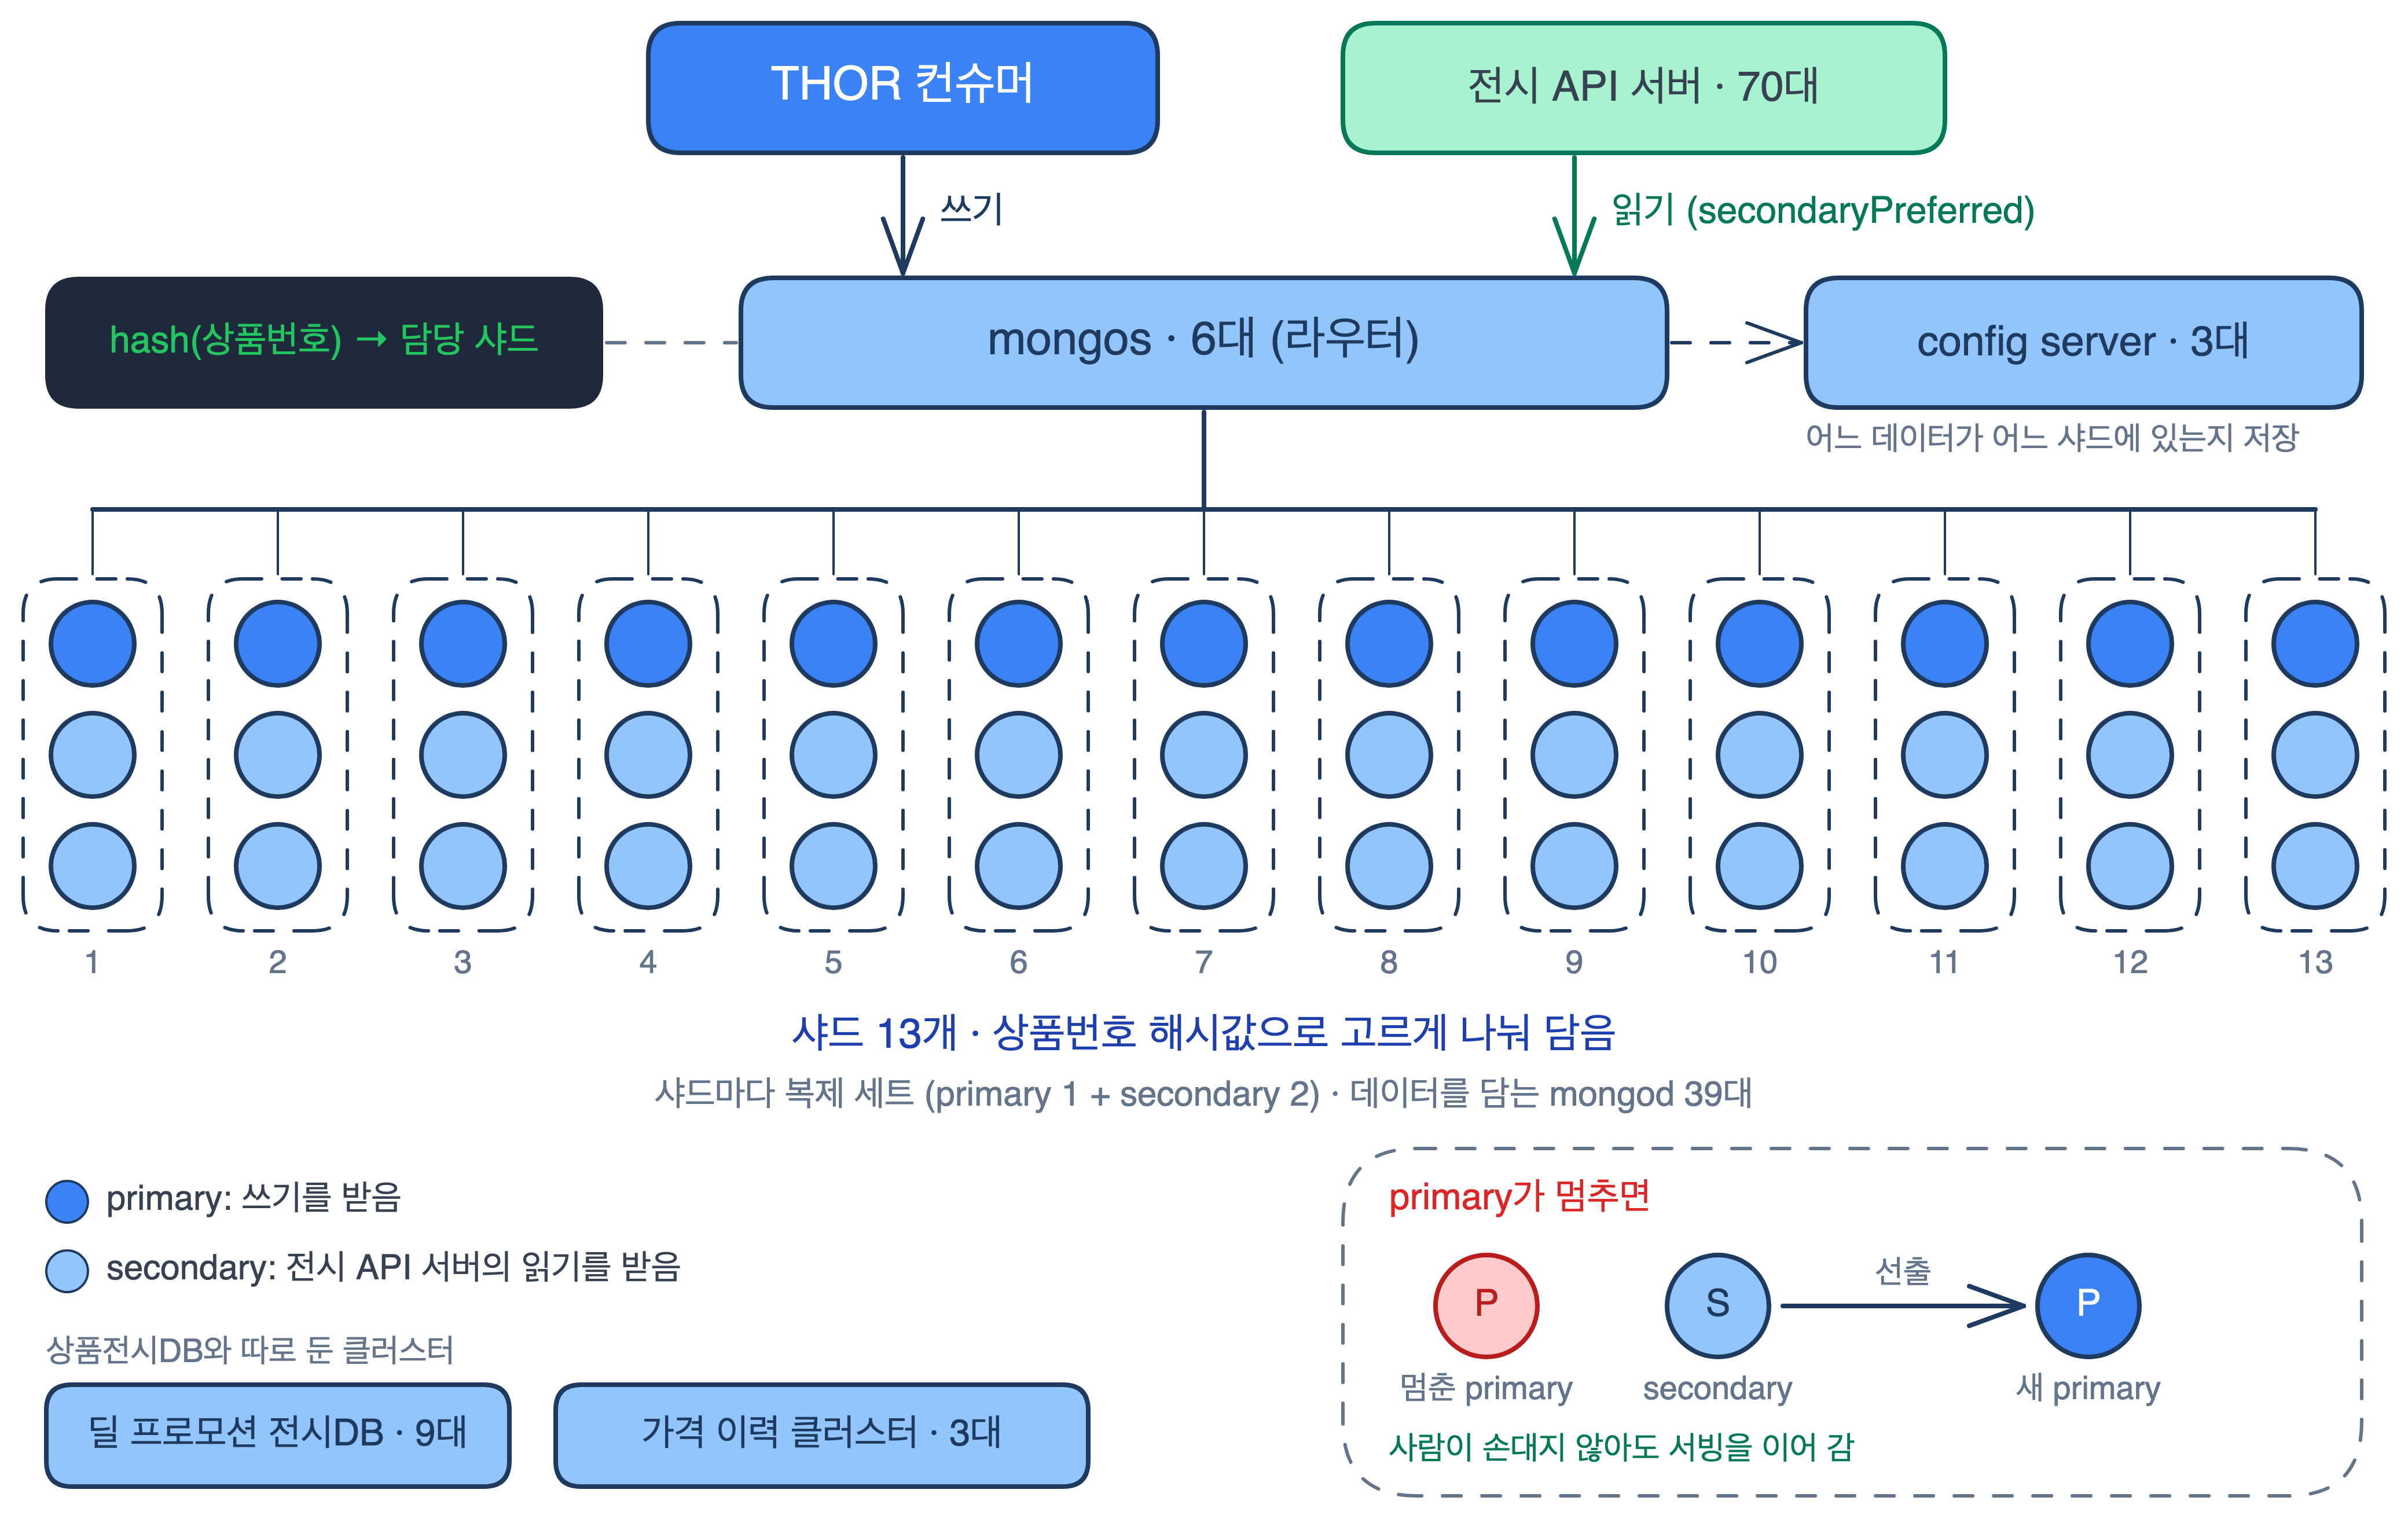
상품 하나를 도큐먼트 하나로 미리 조립해 두고 상품번호(샤드 키)로 찾게 해서,
3.5억 건을 13개 샤드에 나눠 담고도 조회할 때 조인 없이 꺼내 쓸 수 있게 했습니다.
마치며
1부에서는 THOR가 무엇이고 왜 필요했는지, 가격 변경 하나가 원천 DB에서 화면까지 어떻게 닿는지,
그리고 3.5억 건을 어떤 구조로 담는지 살펴봤습니다.
정리하면, THOR는 하루 약 10억 건의 메시지를 near-time으로 원활히 처리하여 전시에 필요한 상품정보를 최적화하여 제공하는 시스템입니다.
THOR를 만든 뒤로 전시 화면은 상품 정보 대부분을 THOR가 만든 데이터에서 읽습니다.
지금 THOR는 하루 약 10억 건 이상의 메시지를 처리하고, 전시 API 서버는 이 데이터로 그랜드십일절 같은 행사 피크에 80-90K의 TPS 처리합니다.
전시에 새 정보가 필요하거나 데이터에 이슈가 생겨도, 전시서비스개발팀이 직접 고치고 테스트한 뒤 바로 반영합니다.
THOR 시스템을 다루면서 가장 많이 고민한 것은 이렇게 많은 상품 정보를 빠르게, 그리고 빠짐없이 최신으로 맞추는 방법이었습니다.
갱신이 누락되거나 잘못된 데이터로 갱신되어있는경우, 메시지가 유실되거나 잘못 overwrite 되는 원인을 트래킹하여 찾아내고 동일문제가 생기지않도록 개선하는 작업을 해왔습니다.
2부에서는 변경이 몰리거나 처리에 실패해도 THOR가 늦지 않게, 빠짐없이 반영하는 방법을 소개합니다.
3부에서는 서비스를 운영하면서 MongoDB와 Kafka 클러스터의 버전을 올리고, 새로 구성한 클러스터로 옮긴 과정을 다룹니다.
긴 글 읽어 주셔서 감사합니다.
참고 자료
- [11번가 기술블로그] 전시 딜 내재화 프로젝트 회고
- [11번가 기술블로그] 한계에 도달한 전시 서버, 그리고 우리의 해답
- [MongoDB 문서] 데이터 모델링
- [MongoDB 문서] 샤딩(Sharding)
- [MongoDB 문서] 복제(Replication)
- [MongoDB 문서] 커버드 쿼리(Query Optimization)